
Une usine peut produire des milliers de mesures par minute sans savoir quelle machine risque de s’arrêter. Le Smart data répond à ce décalage : plutôt que de conserver et traiter toutes les informations de la même manière, il sélectionne celles qui sont fiables, utiles et disponibles au moment où une décision doit être prise. Les données intelligentes ne remplacent pas le Big data : elles en organisent l’exploitation en fonction d’un objectif concret, qu’il s’agisse d’éviter une panne, d’ajuster une offre ou de détecter une fraude.
La différence se joue dans la chaîne de traitement. Une donnée de température ne devient pas utile par sa seule présence dans un entrepôt. Il faut savoir quel équipement l’a émise, vérifier sa qualité, la comparer à un seuil pertinent et transmettre une alerte compréhensible à la bonne personne. Dans l’Internet des objets, une partie de ce tri peut s’effectuer près du capteur, en quelques secondes, au lieu d’attendre un transfert vers un système central.
En bref
- Le Big data décrit la collecte et le traitement de volumes importants, issus de sources variées et produits à des rythmes différents.
- Le Smart data privilégie la pertinence, la fiabilité et l’usage immédiat des informations.
- Les deux approches sont complémentaires : les mégadonnées alimentent l’analyse, tandis que le tri ciblé soutient la prise de décision.
- Avant un déploiement, définissez l’action attendue, la qualité des données nécessaire et les règles de conservation.
Smart data : définition et fonctionnement des données intelligentes
Le Smart data désigne une approche de l’analyse de données qui repère, dans un ensemble plus large, les informations capables de répondre à une question opérationnelle. La sélection peut s’appuyer sur des règles, des modèles statistiques ou des algorithmes. Le terme ne correspond pas à un format de fichier ni à une technologie unique : il décrit une manière de traiter les données en fonction de leur usage.
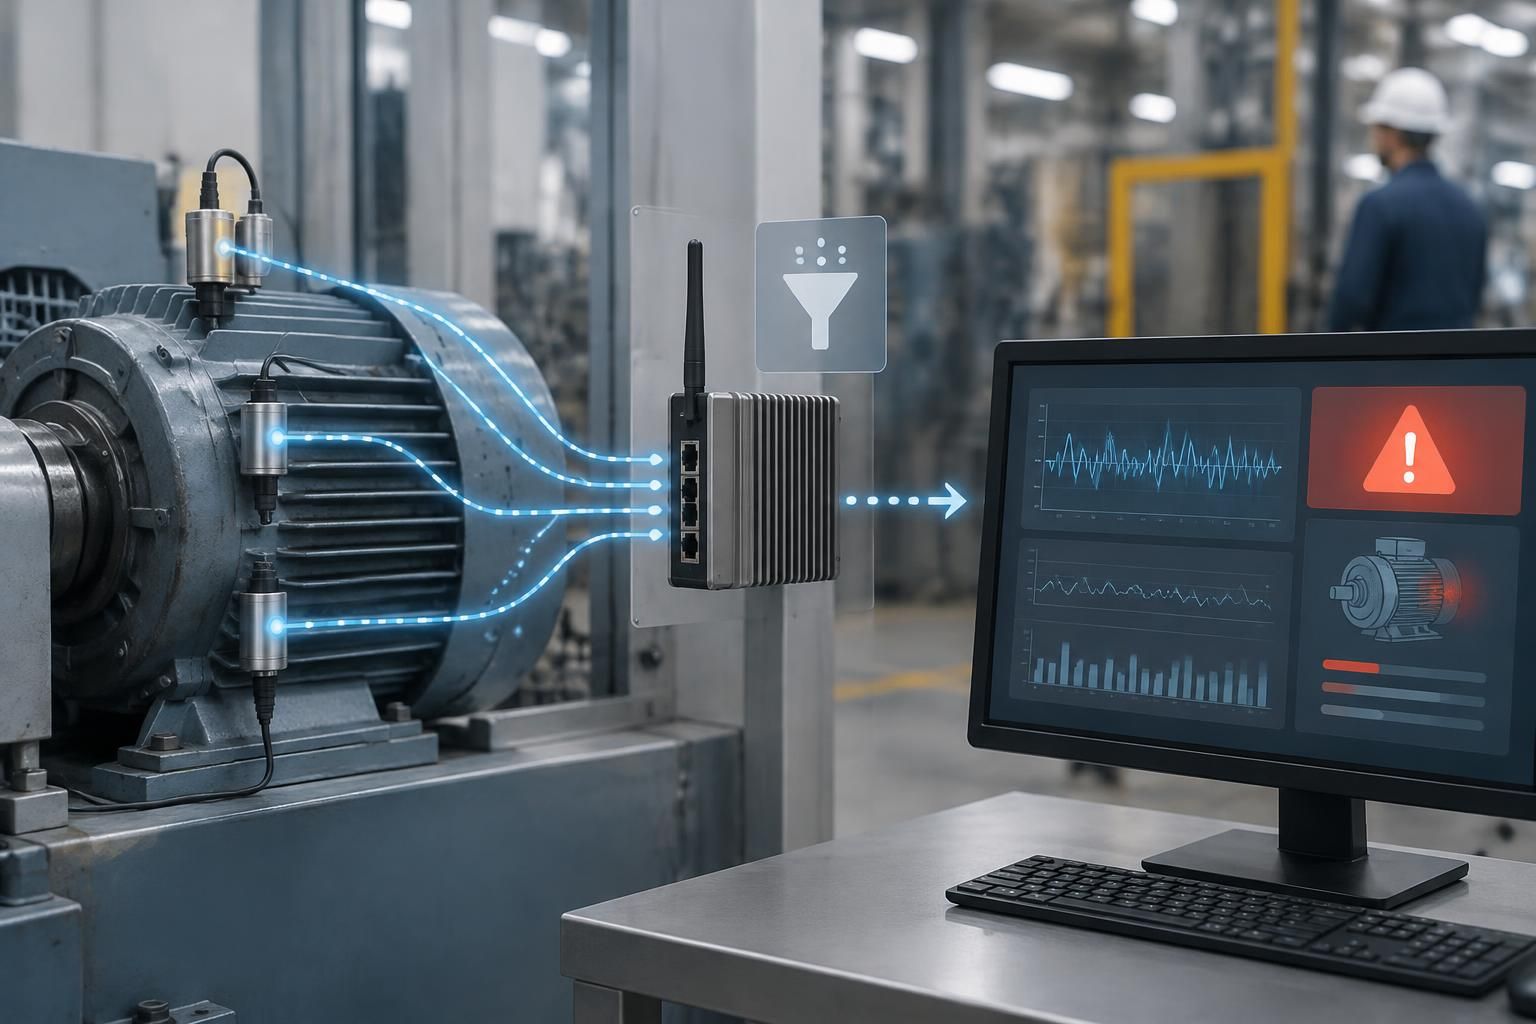
Dans une installation industrielle, des capteurs peuvent transmettre la température, les vibrations et la consommation électrique d’un moteur. Si l’objectif est de repérer une dérive mécanique, la valeur utile n’est pas forcément chaque mesure isolée. C’est plutôt une variation anormale, confirmée par plusieurs relevés et rapprochée du régime de fonctionnement de l’équipement.
Le tri peut s’effectuer dans une passerelle ou directement sur un appareil, au plus près de la source. Cette organisation, souvent associée à l’edge computing, limite les échanges inutiles et permet de réagir sans attendre qu’un flux complet soit envoyé vers un serveur central. Elle exige toutefois de définir précisément les règles locales et les conditions de remontée des alertes.
Le traitement en temps réel n’est pas une promesse générale de rapidité. Il doit correspondre à un délai acceptable pour l’usage : une alerte de sécurité n’a pas les mêmes contraintes qu’un rapport mensuel de consommation. Pour comprendre le rôle des équipements qui font circuler ces mesures, le dossier sur les passerelles IoT et leurs protocoles donne un point de départ utile. La donnée n’est intelligente que si son traitement débouche sur une action définie.
Big data et Smart data : quelles différences pour l’entreprise ?
Le Big data, ou mégadonnées, concerne des ensembles de données caractérisés par leur volume, leur variété et leur vélocité. Les sources peuvent inclure des transactions, des journaux logiciels, des objets connectés, des commentaires en ligne ou des données de localisation. Ces informations ne sont pas toujours structurées de la même manière et leur exploitation nécessite des outils capables de les collecter, de les stocker et de les rapprocher.
Le Smart data intervient lorsqu’une entreprise précise ce qu’elle cherche à savoir et sélectionne les données qui peuvent éclairer cette question. Un service commercial peut analyser un historique d’achats pour adapter une campagne. Une équipe de maintenance peut retenir les mesures liées aux vibrations et à la température plutôt que d’archiver sans distinction chaque signal émis par une machine.
On présente parfois la véracité et la valeur comme deux dimensions supplémentaires aux trois V du Big data. C’est une grille de lecture pratique, mais pas une règle universelle de conception. En production, ces critères doivent se traduire en contrôles concrets : unités cohérentes, horodatage exploitable, capteur identifié, taux de données manquantes connu et indicateur lié à une décision réelle.
| Critère | Big data | Smart data |
|---|---|---|
| Question principale | Comment gérer un ensemble vaste et varié ? | Quelle information sert l’action visée ? |
| Priorité | Volume, variété et vitesse de traitement | Pertinence, fiabilité et valeur d’usage |
| Exemple | Historique de mesures de nombreux équipements | Alerte étayée par une dérive observée |
| Rôle dans l’architecture | Collecter, conserver et explorer | Filtrer, interpréter et déclencher une action |
Opposer ces approches conduit souvent à de mauvais choix. Une entreprise n’a pas à choisir entre tout stocker et ne rien garder : elle peut archiver certains historiques pour l’analyse, tout en filtrant localement les événements qui nécessitent une réaction rapide. Le bon compromis dépend du coût de transmission, des délais, des obligations de conservation et de la valeur attendue.
Qualité des données, gouvernance et prise de décision
Une donnée sélectionnée reste inutile si elle est erronée. Un capteur mal positionné, une horloge décalée ou une unité mal interprétée peut produire une alerte trompeuse. La qualité des données doit donc être vérifiée à plusieurs étapes, depuis la mesure jusqu’à son affichage dans un tableau de bord.
Une PME peut commencer avec une liste de contrôles simple : vérifier les plages de valeurs attendues, repérer les mesures absentes, détecter les doublons et conserver l’identifiant de l’équipement. Il faut aussi distinguer une absence de données d’une valeur nulle. Sur une ligne de production, cette différence peut séparer un arrêt réel d’un défaut de communication.
La gouvernance inclut également la protection des informations personnelles. Le règlement général sur la protection des données (RGPD) impose notamment de définir les finalités, de limiter les informations collectées à ce qui est nécessaire et d’encadrer leur durée de conservation. Une segmentation marketing fondée sur les comportements doit être examinée sous cet angle, au même titre que les journaux de localisation ou les données issues d’une application.
Dans la relation client, une personnalisation peut améliorer la pertinence d’une offre, mais elle ne justifie pas une collecte sans limite. Un score doit avoir un usage explicite, une base de calcul compréhensible par les équipes et des garde-fous contre les erreurs de classement. La personnalisation client fonctionne mieux lorsque les données utilisées sont limitées, fraîches et directement liées au service proposé.
Pour rendre une décision vérifiable, un tableau de bord doit afficher plus qu’un indicateur coloré. Il doit permettre de retrouver la période observée, la source de la mesure et le seuil déclenchant l’alerte. Sans ces éléments, l’équipe voit un signal, mais ne peut pas savoir s’il mérite une intervention.
Six cas d’usage du Smart data, du commerce à l’industrie
Les cas d’usage les plus convaincants partent d’un problème clairement formulé. Dans le commerce, l’analyse de transactions et de retours clients peut aider à proposer une promotion adaptée. L’intérêt n’est pas de prédire chaque geste d’un consommateur, mais de mesurer si une offre ciblée améliore réellement le résultat sans dégrader la confiance.
Dans les transports, des données embarquées peuvent contribuer à détecter des comportements de conduite à risque. Pour un véhicule automatisé, les décisions touchant au freinage ou à la direction relèvent de systèmes de sûreté conçus et validés à cette fin : un traitement analytique général ne saurait s’y substituer. Le délai et les procédures de validation comptent autant que le modèle de détection.
- Télécommunications : ajuster l’allocation de ressources réseau selon la demande observée, en tenant compte des limites de capacité.
- Santé : suivre des constantes pour signaler une évolution à un professionnel, sans remplacer son jugement clinique.
- Services financiers : repérer des opérations atypiques et les soumettre à des contrôles complémentaires avant décision.
- Industrie : rapprocher vibrations, température et cycles de fonctionnement afin de planifier une intervention.
La maintenance prédictive illustre bien la différence entre données nombreuses et données utiles. Une usine peut collecter des mesures sur plusieurs lignes, mais ne doit pas déclencher une intervention sur une seule valeur aberrante. Une règle de confirmation, fondée sur la répétition du signal ou sur plusieurs paramètres, réduit les alertes inutiles et aide les techniciens à prioriser leur tournée.
Un autre exemple concerne les bâtiments et les territoires : croiser consommation, occupation et conditions de fonctionnement peut orienter une action sur le chauffage ou l’éclairage. Les données doivent toutefois être agrégées et utilisées selon une finalité définie. Le dossier consacré aux données IoT des territoires permet d’élargir la réflexion au-delà d’un site industriel.
Déployer une démarche Smart data sans accumuler les outils
Un déploiement utile commence par une décision à améliorer, pas par le choix d’une plateforme. Il faut nommer le rôle qui recevra l’information, l’action qu’il pourra engager et le délai dont il dispose. Si aucune action ne change après l’affichage d’un indicateur, la collecte mérite d’être réexaminée.
Pour un premier essai de maintenance, une équipe peut instrumenter un équipement représentatif, conserver une période de référence et comparer les alertes aux constats des techniciens. Le test doit documenter le type de capteur, son emplacement, la fréquence d’échantillonnage et les conditions de fonctionnement. Cette méthode évite d’attribuer au modèle une différence qui vient en réalité d’un capteur déplacé ou d’une machine utilisée autrement.
Avant d’étendre le dispositif, vérifiez les points suivants :
- La décision attendue et la personne responsable sont définies.
- Les capteurs, unités, horodatages et seuils sont documentés.
- Les données personnelles sont limitées à la finalité déclarée et leur conservation est encadrée.
- Les alertes sont comparées aux événements réels, puis ajustées pour éviter le bruit.
- Les coûts de réseau, de stockage, de maintenance et d’intégration sont suivis.
Un tableau de bord d’indicateurs ne remplace pas cette vérification. Il aide à rendre les résultats visibles, à condition que chaque indicateur possède une définition stable et une source traçable. Pour une équipe qui démarre, mieux vaut quelques mesures validées et discutées avec les opérateurs qu’un écran chargé de courbes jamais consultées.
Le Smart data n’est donc pas une couche magique ajoutée au Big data. C’est une discipline de sélection et de validation : conserver ce qui sert, traiter près de la source lorsque le délai l’impose et supprimer les alertes qui ne changent aucune décision. Le test le plus parlant reste simple : quelle action concrète devient possible grâce à cette donnée ?
Le Smart data remplace-t-il le Big data ?
Non. Le Big data permet de collecter et d’explorer de grands ensembles d’informations. Le Smart data sélectionne les données utiles à une décision précise. Les deux démarches peuvent coexister dans une même architecture.
Le Smart data implique-t-il toujours un traitement en temps réel ?
Non. Le traitement en temps réel est pertinent lorsqu’un délai de réaction court est nécessaire, par exemple pour une alerte de fonctionnement. Pour une analyse périodique, un traitement différé peut suffire.
Comment améliorer la qualité des données avant un projet ?
Documentez les sources, les unités et les horodatages, puis contrôlez les valeurs manquantes, les doublons et les plages plausibles. Vérifiez aussi les capteurs sur le terrain avant d’interpréter leurs mesures.
Quels secteurs utilisent le Smart data ?
Le commerce, les télécommunications, la santé, la finance, les transports et l’industrie peuvent l’utiliser. Le cas pertinent dépend de l’action à soutenir, des contraintes de délai et de la fiabilité des données disponibles.